
Архитектура подсистем памяти в Enterprise-серверах: баланс Storage (SAS/NVMe) и RAM
Архитектура подсистем памяти в Enterprise-серверах: баланс Storage (SAS/NVMe) и RAM для минимизации Bottlenecks и оптимизации TCO
Memory Wall и Storage Latency: почему CPU простаивает
Вычислительная плотность процессоров растет быстрее, чем пропускная способность подсистемы памяти. С 2003 по 2023 год производительность CPU выросла на порядки, тогда как латентность DRAM практически не изменилась и остается на уровне 60–100 наносекунд. Один цикл процессора на частоте 3 ГГц занимает примерно 0,33 нс. За время ожидания данных из DRAM ядро пропускает сотни циклов. При обращении к накопителю через SAS-интерфейс добавляются миллисекунды — это уже миллионы потерянных циклов.
Для транзакционных СУБД и платформ виртуализации это означает прямые финансовые потери: лицензии на ядра CPU оплачены, а утилизация ядер в часы пиковой нагрузки не превышает 30–40% из-за I/O-ожиданий. Профилирование PostgreSQL и MS SQL на реальных конфигурациях показывает, что при недостаточной глубине очереди (Queue Depth) и высокой латентности диска время отклика транзакции растет нелинейно относительно роста нагрузки на CPU.
Накопители (Storage Tier): SAS 10K, Enterprise SSD, NVMe
Выбор накопителя определяет нижнюю границу латентности всей подсистемы. Ключевые метрики — IOPS при случайном доступе 4K, средняя латентность и ресурс записи (DWPD).
| Параметр | SAS 10K HDD | Enterprise SATA SSD | Enterprise NVMe SSD |
|---|---|---|---|
| Random 4K Read IOPS | 150–200 | 80K–100K | 1M+ |
| Средняя латентность | 4–6 мс | 80–200 мкс | 20–100 мкс |
| Последовательная передача | до 190 МБ/с | до 550 МБ/с | 6,5–14,5 ГБ/с |
| DWPD (typical) | N/A (limited by TBW) | 1–3 | 1–3 (mixed-use) |
Потребительские SSD формально демонстрируют высокие пиковые IOPS, но их ресурс при постоянной записи исчерпывается за недели. Для серверного накопителя критичен DWPD — количество полных перезаписей объема диска в сутки, которое гарантируется в течение гарантийного срока. Read-intensive класс (1 DWPD) подходит для cold data и архивов. Mixed-use (3 DWPD) — минимальный порог для журналов транзакций и логов СУБД. Write-intensive (10 DWPD и выше) применяется в кэш-тирах и системах с интенсивной записью.
Кейс: HP EG0300FCVBF 300GB SAS 10K в транзакционных системах
Накопитель HP EG0300FCVBF (PN: 507284-001) — 2,5" SAS 6G, 10 000 RPM, кэш 32 МБ, интерфейс SAS-2 (6 Гбит/с). Формально это устаревший форм-фактор для 2026 года. Однако для специфических задач он сохраняет обоснованность:
1. Журналы транзакций СУБД. PostgreSQL WAL, MS SQL Transaction Log и Oracle Redo Log пишутся последовательно с малым размером блока. SAS 10K обеспечивает стабильную последовательную запись без деградации, характерной для TLC NAND при заполнении буфера SLC.
2. RAID-массивы для логов. При объединении нескольких дисков в RAID 10 достигается 300–400 IOPS на дисковую группу, что достаточно для сервисов с 200–500 TPS без использования SSD.
3. Совместимость с legacy-платформами. HP Gen7 и более ранние серверы не поддерживают NVMe без дополнительных контроллеров. Использование оригинальных SAS-накопителей с подтвержденными PN (507129-004, 693569-001) гарантирует прохождение POST без ошибок в HP Smart Array.
Ограничение: для виртуализации с сотнями ВМ SAS 10K не подходит — Queue Depth и IOPS недостаточны. Этот накопитель следует рассматривать как элемент write-intensive тира, а не как основное хранилище.
Оперативная память (RAM Tier): RDIMM vs LRDIMM
Подсистема RAM определяет, насколько эффективно CPU сможет обрабатывать данные, не уходя в I/O-ожидание. В 2–4 сокетных серверах ключевым ограничением становится нагрузка на контроллер памяти при заполнении всех слотов.
RDIMM vs LRDIMM: архитектурная разница
RDIMM (Registered DIMM) буферизует адресные и командные линии, но данные идут напрямую к контроллеру. При установке 2–4 рангов на канал контроллер вынужден управлять значительной емкостной нагрузкой, что ограничивает частоту и стабильность.
LRDIMM (Load Reduced DIMM) добавляет буфер данных (DB) между DRAM и контроллером памяти. Контроллер «видит» не реальные ранги, а одну буферизованную нагрузку. Это позволяет устанавливать больше модулей без снижения частоты.
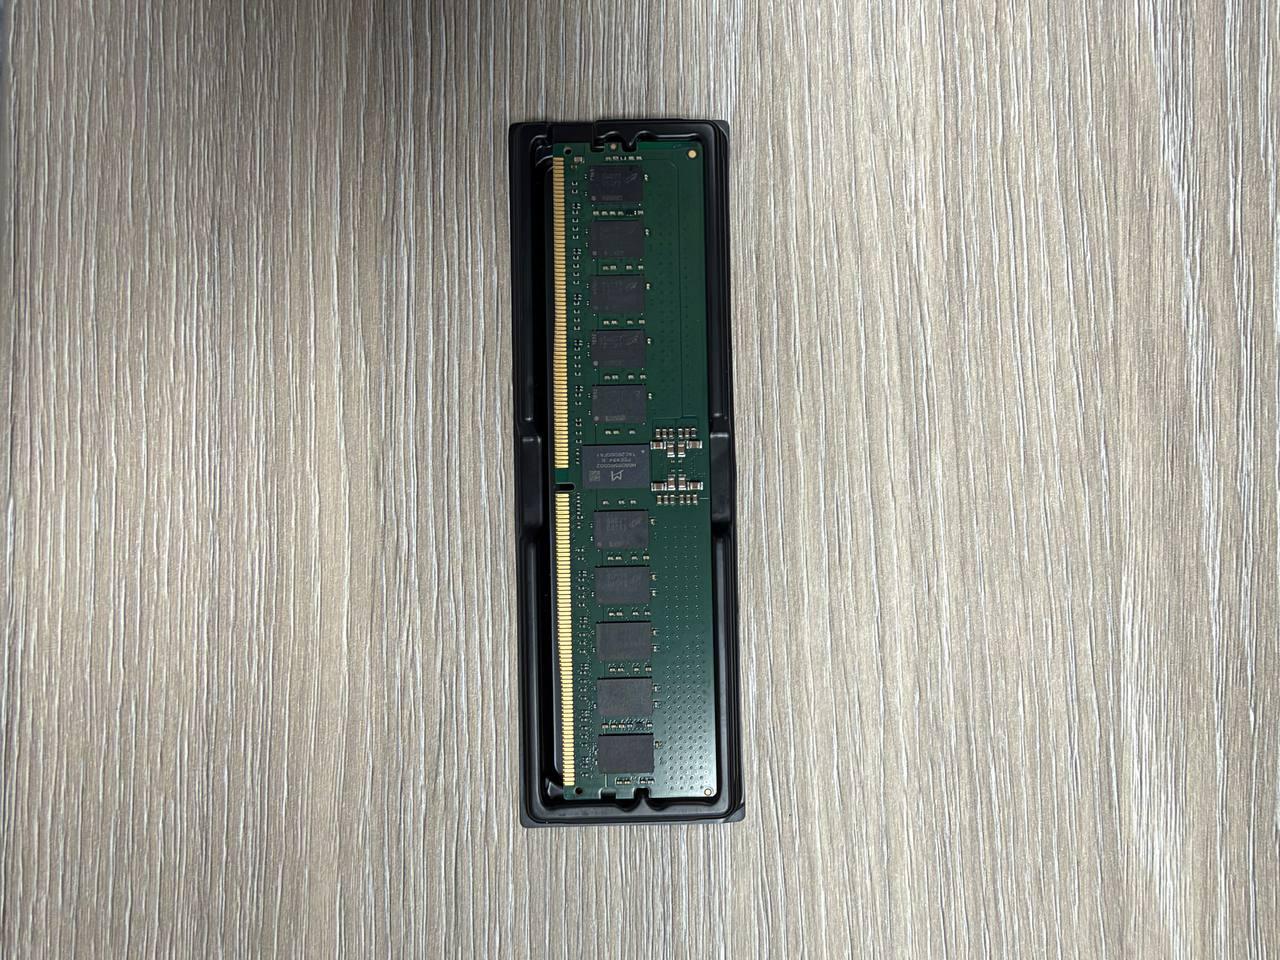
Hynix HMA84GL7MMR4N-TF: 32GB DDR4-2133 4Rx4 LRDIMM
Модуль HMA84GL7MMR4N-TF — 32 ГБ DDR4-2133 (PC4-17000), 4Rx4 (четырехранговая), ECC Load Reduced, 288-пиновый, напряжение 1,2 В. Его ключевая особенность — архитектура 4Rx4 в сочетании с LRDIMM-буферизацией.
Четырехранговые модули без буферизации данных создают настолько высокую емкостную нагрузку, что контроллер памяти вынужден снижать частоту. LRDIMM снимает эту проблему: контроллер работает с одной нагрузкой на канал, а буфер распределяет операции между четырьмя рангами. В 2-сокетных серверах с 8–12 каналами на процессор это позволяет заполнить все слоты без падения частоты ниже 2133 MT/s.
При оценке задержек важно учитывать CAS Latency (CL) — количество тактов между запросом на чтение и выдачей данных. Для DDR4-2133 типичное значение CL15-CL16. Снижение частоты с 2400 до 2133 MT/s увеличивает реальную латентность на 5-10 нс, что в масштабах транзакционной нагрузки на СУБД может дать прирост времени отклика на 2-3%.
Практический эффект для виртуализации: каждый модуль на 32 ГБ в конфигурации 12 модулей на сокет дает 384 ГБ RAM на сокет. Для плотной виртуализации (VDI, тестовые стенды, консолидация legacy-сервисов) это критически важный сценарий, где емкость важнее пиковой пропускной способности.
ECC и аптайм: WHEA errors как индикатор деградации
ECC-память исправляет однобитные ошибки автоматически. Однако частота скорректированных ошибок — предиктор отказа модуля. Windows Hardware Error Architecture (WHEA) ведет мониторинг страниц памяти с повторяющимися ошибками и при превышении порога инициирует вывод страницы из эксплуатации (Predictive Failure Analysis). На Linux аналогичную функцию выполняет EDAC (Error Detection and Correction).
Игнорирование WHEA Logger ID 47 в Windows Server приводит к накоплению некорректируемых ошибок и внезапным зависаниям. Для СУБД с буферным пулом в десятки гигабайт одна некорректированная ошибка в странице данных означает потерю транзакции или повреждение индекса.
Баланс подсистемы: RAM/Storage IOPS для разных задач
Соотношение RAM и Storage IOPS определяется профилем нагрузки. Ниже — ориентировочные конфигурации для типовых enterprise-сценариев.
| Задача | RAM на ядро | Требуемые IOPS (4K random) | Латентность Storage | Рекомендуемый тир |
|---|---|---|---|---|
| PostgreSQL OLTP | 4–8 ГБ | 5K–15K | < 1 мс | NVMe mixed-use |
| 1C:Предприятие (100+ users) | 8–16 ГБ | 10K–30K | < 0,5 мс | NVMe + RAM-кэш СУБД |
| VDI (500+ сессий) | 6–10 ГБ | 50K–100K | < 0,2 мс | NVMe read-intensive + LRDIMM |
| AI-инференс (LLM) | 64–128 ГБ | 1K–5K (KV cache offload) | < 1 мс | NVMe write-intensive (3+ DWPD) |
| Логи/аудит | 1–2 ГБ | 200–500 | < 5 мс | SAS 10K RAID 10 |
Для AI-инференса с длинным контекстом (KV cache offload) ключевым параметром становится endurance накопителя: непрерывная запись KV-блоков при duty cycle 24/7 требует минимум 3 DWPD. Read-intensive NVMe (1 DWPD) в этом сценарии исчерпает ресурс за несколько месяцев.
Для PostgreSQL и 1C критична не только пропускная способность, но и RAM: увеличение shared_buffers до 8–16 ГБ на инстанс снижает частоту обращений к storage. Каждое обращение к NVMe — это 20–100 мкс латентности, тогда как попадание в shared_buffers — единицы наносекунд.
Экономика и TCO: параллельный импорт против ожидания вендора
Сроки поставки оригинальных комплектующих от HPE, Dell и Lenovo через официальные каналы в 2026 году составляют 8–12 недель. Для критичных систем это означает простой или работу на деградировавшем оборудовании. Параллельный импорт через склады в Москве сокращает срок до 1–3 дней при наличии позиции.
TCO складывается из трех компонентов:
- Стоимость простоя. Час недоступности СУБД для финансовой организации оценивается в миллионы рублей. Ожидание компонента 12 недель несопоставимо с переплатой 10–15% за наличие.
- Совместимость по PN. Параллельный импорт без верификации Part Number приводит к покупке модулей, которые POST не пропускает или работают на пониженной частоте. Подбор по PN вендора (HPE SmartMemory, Dell EMC-certified) исключает этот риск.
- Продление жизненного цикла. Замена отдельных компонентов (RAM, SAS-накопители) в серверах Gen7–Gen9 дешевле замены платформы целиком. LRDIMM 32GB DDR4-2133 продлевает жизнь 2-сокетным платформам, которые иначе пришлось бы выводить из эксплуатации из-за нехватки RAM.
Дополнительный фактор экономии — снижение затрат на лицензии. При грамотном балансе RAM и Storage (достаточный объем памяти для кэширования горячих данных) утилизация CPU возрастает с 30–40% до 70–80%, что позволяет отложить закупку новых серверов или сократить количество лицензируемых ядер.
Инженерный подбор по PN / BOM-листу
СтокСвитч поставляет серверные комплектующие из наличия в Москве с гарантией. Подбор выполняется по Part Number вендора: для HPE — по 507284-001, 507129-004, 693569-001; для памяти — по HMA84GL7MMR4N-TF и аналогам. Верификация совместимости проводится до отгрузки.
Для формирования BOM-листа под конкретную задачу (PostgreSQL, VDI, 1C, AI-инференс) направьте конфигурацию сервера и требуемый профиль нагрузки на sales@stockswitch.ru. Инженерный подбор включает проверку совместимости RAM с контроллером памяти, расчет Queue Depth для Storage-тира и рекомендации по DWPD для write-intensive сценариев.